-
세금계산서 OCR - ocr 오픈소스 라이브러리 인식모델 비교projects/ocr 2026. 7. 30. 17:45
OCR 모델을 비교 테스트했다.
"테이블 전체 한 장보다 셀 별로 나눈 여러 장이 detection(이하 det) 및 recognition(이하 rec)의 추론 속도와 정확성이 더 높다."
det 모델은 성능이 괜찮은 PP-OCRv6-tiny-det로 선택했다. 이후 rec 모델을 비교하기 위해 det 모델 고정 후 rec 모델별로 테스트했다.
detection 모델(PP-OCRv6-tiny-det)로 얻은 174 개 크롭 이미지를 rec 모델별로 돌렸다. cpu only로 추론 가속 없이 (safetensors g혹은 pth, pt포맷)를 테스트했다.
테스트 환경: M1 Pro (8C CPU / 14C GPU) | 32GB RAM
1. opencv 로 셀별 크롭
2. 각 셀 별로 PP-OCRv6-tiny-det 모델로 bbox 추론,
3. 해당 bbox를 입력으로, 여러 recognition 모델을 추론하고 비교한다.1. Tesseract
HP 연구소에서 1985년 처음 개발되어 2005년 오픈소스로 공개된 후 구글이 개발을 이어받아 발전시킨, 가장 오래되고 널리 쓰이는 오픈소스 광학 문자 인식(OCR) 엔진
같은 결로 조금 더 붙이면:
- 4.0 버전부터 기존의 문자 패턴 매칭 방식 대신 LSTM 기반 신경망 엔진을 도입해 인식률을 크게 개선
- 100개 이상의 언어를 지원하며, 언어별 학습 데이터(traineddata)를 교체·추가하는 방식으로 확장 가능
- Apache 2.0 라이선스, 현재는 구글이 아닌 커뮤니티 주도로 유지·관리됨
- 문자 인식 자체에 특화된 엔진이라 텍스트 영역 검출 성능은 상대적으로 약하고, 문서 스캔본처럼 정형화된 이미지에 강하며 자연 이미지·기울어진 텍스트에는 전처리가 필요
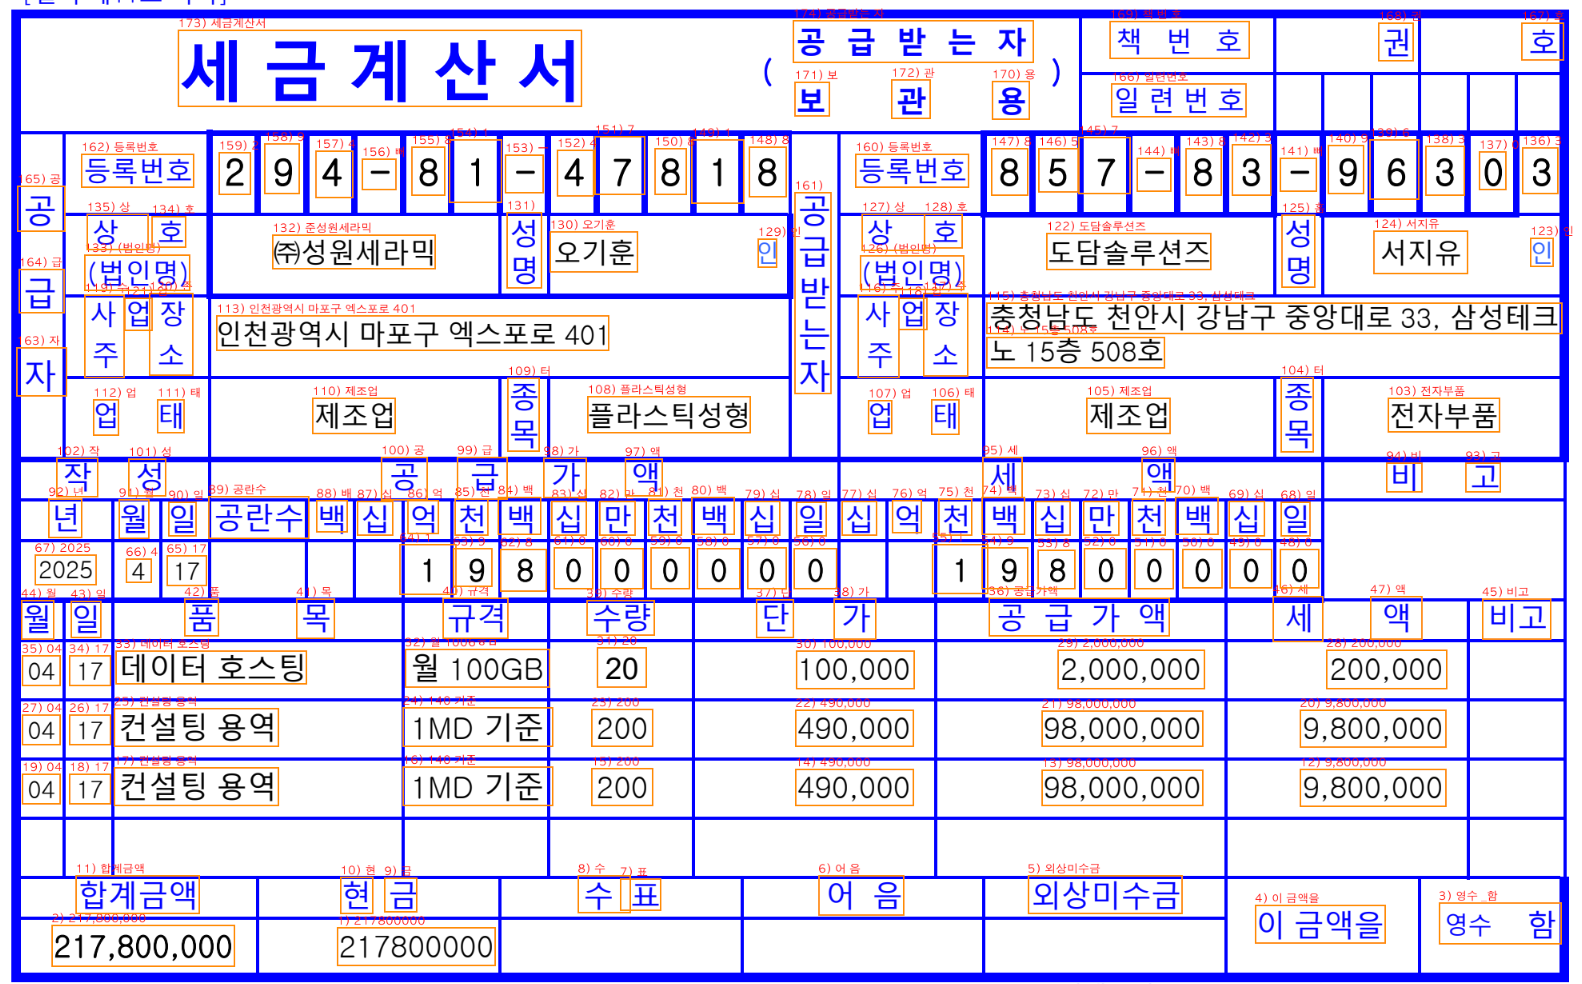
Tesseract (5.2s) 2. PaddleOCR
중국의 IT 기업인 바이두(Baidu)가 개발한 딥러닝 프레임워크인 PaddlePaddle을 기반으로 구축된 오픈 소스 광학 문자 인식(OCR) 툴킷
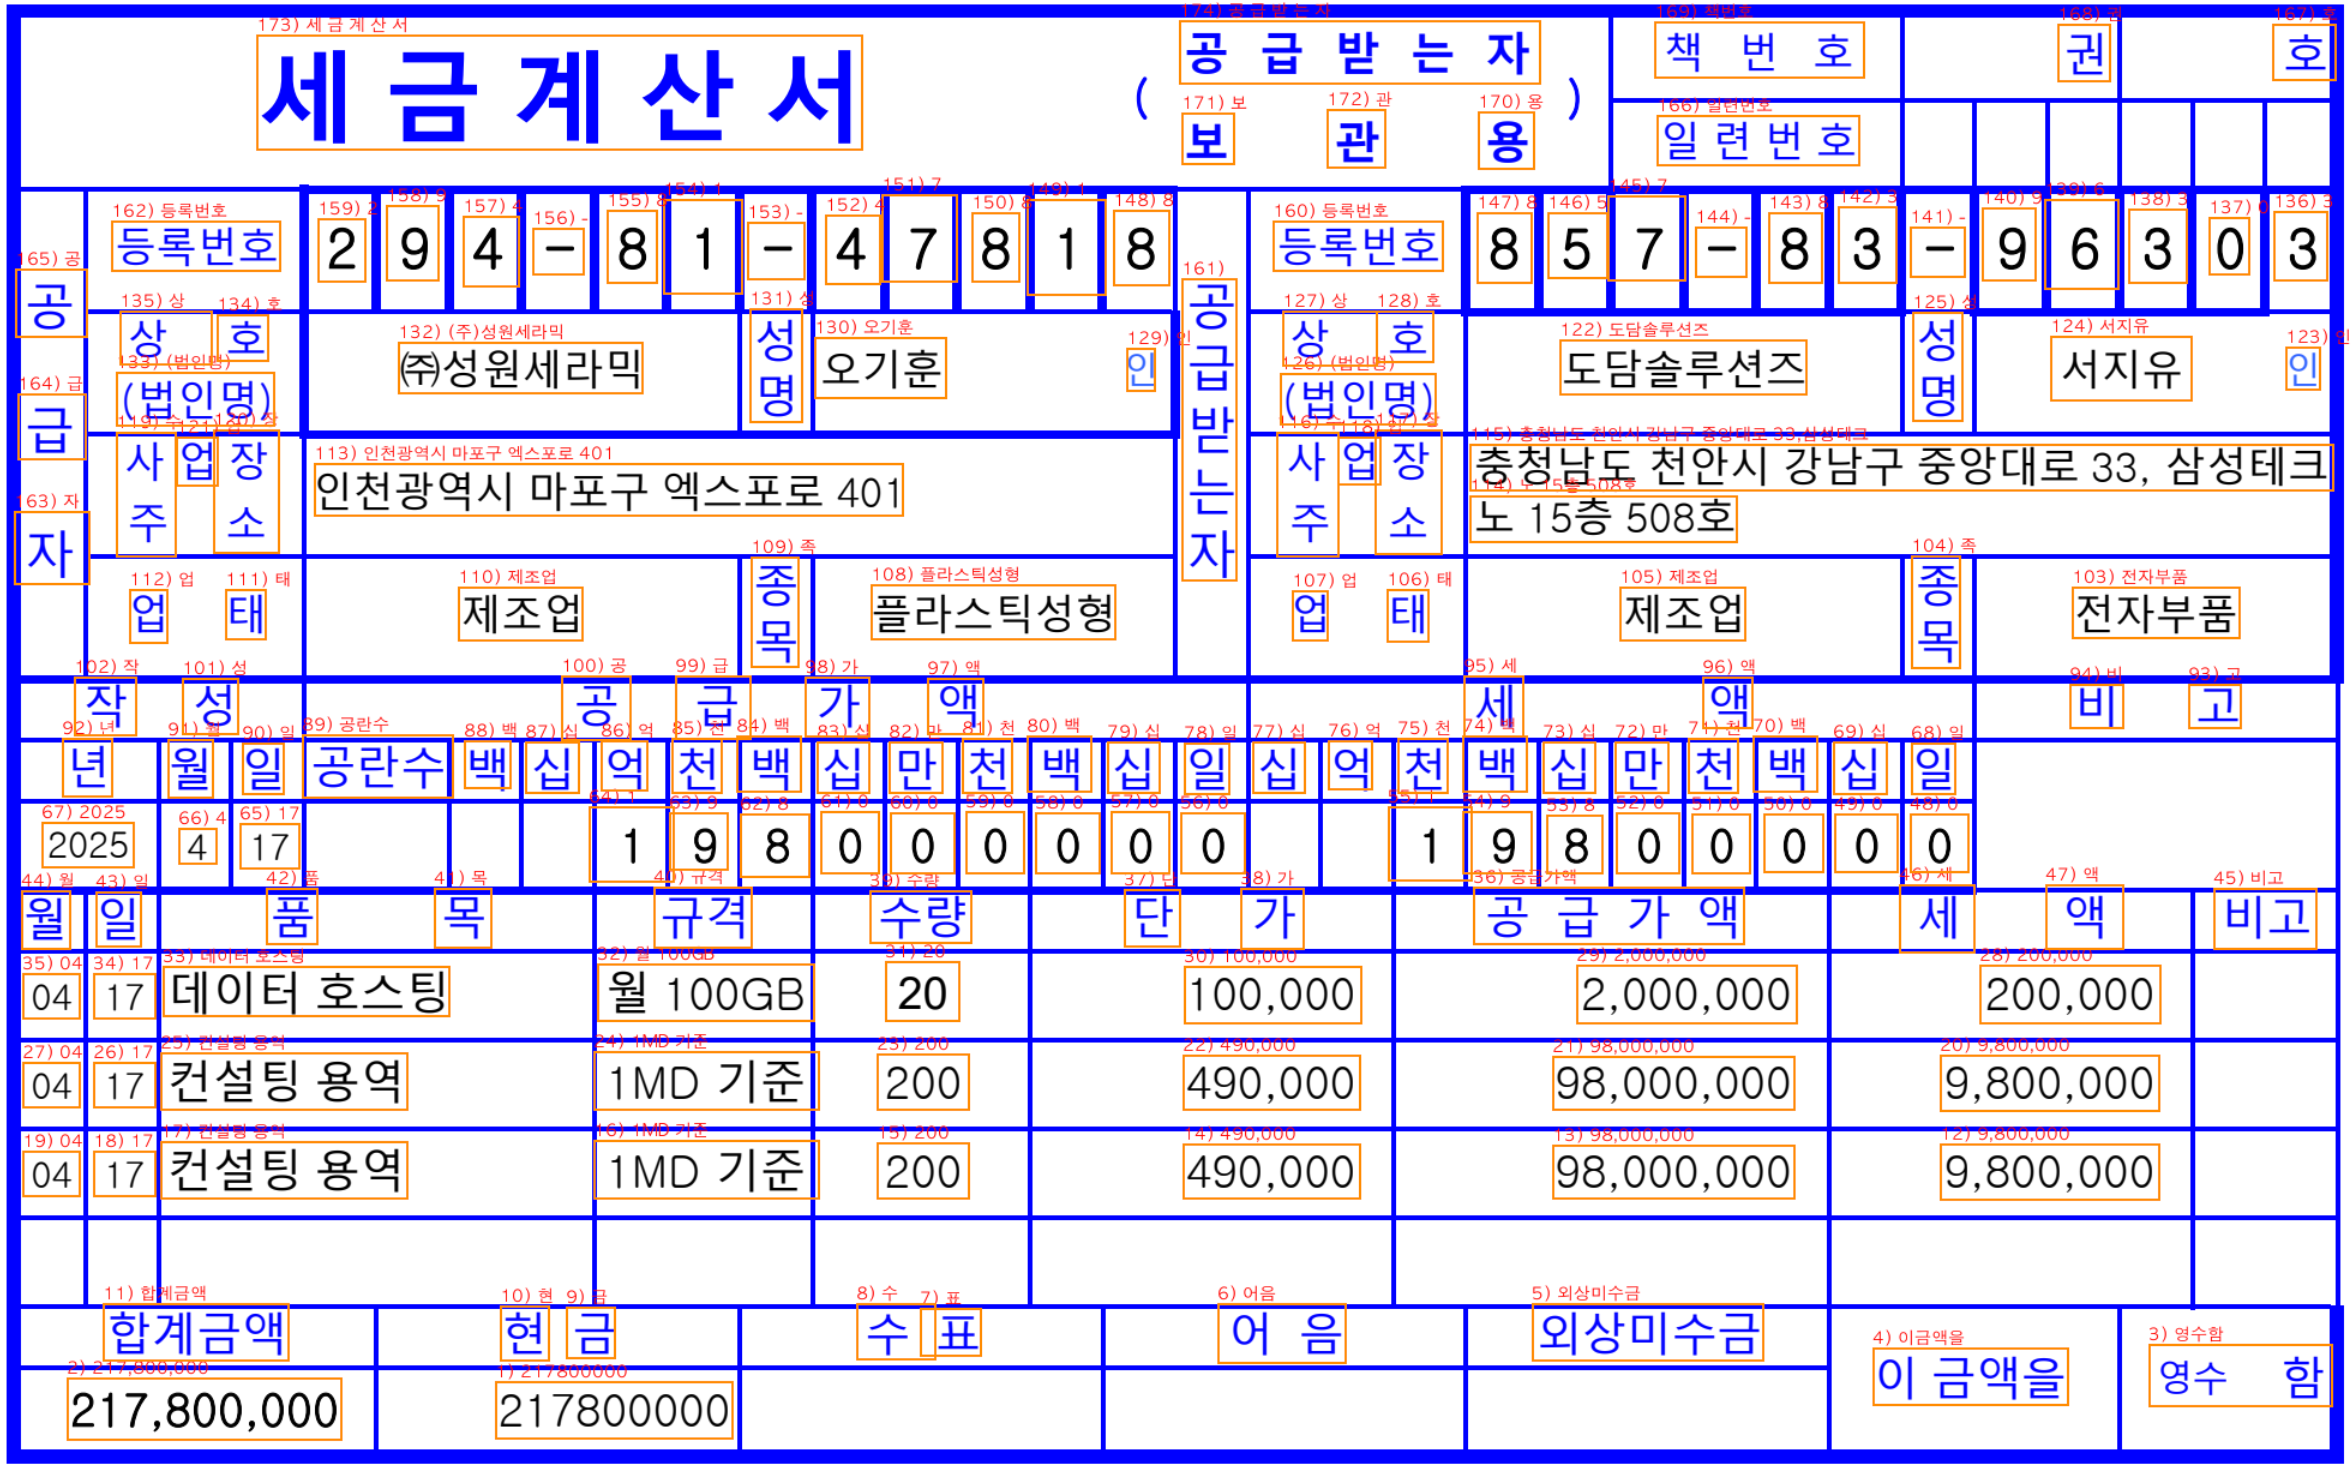
PP-OCRv5-mobile-rec (14s) 3. RapidOCR
PaddleOCR을 기반으로 경량화 및 추론 속도 향상에 초점을 맞춰 재구성한 오픈소스 OCR(광학 문자 인식) 툴킷
- 테스트 생략
4. EasyOCR
Jaided AI에서 개발한, PyTorch 기반으로 텍스트 검출(CRAFT)과 인식(CRNN)을 하나의 파이프라인으로 묶어 제공하는 오픈소스 OCR 툴킷
- 80개 이상 언어 지원, 한국어 포함. easyocr.Reader(['ko','en']) 한 줄로 다국어 동시 인식 가능
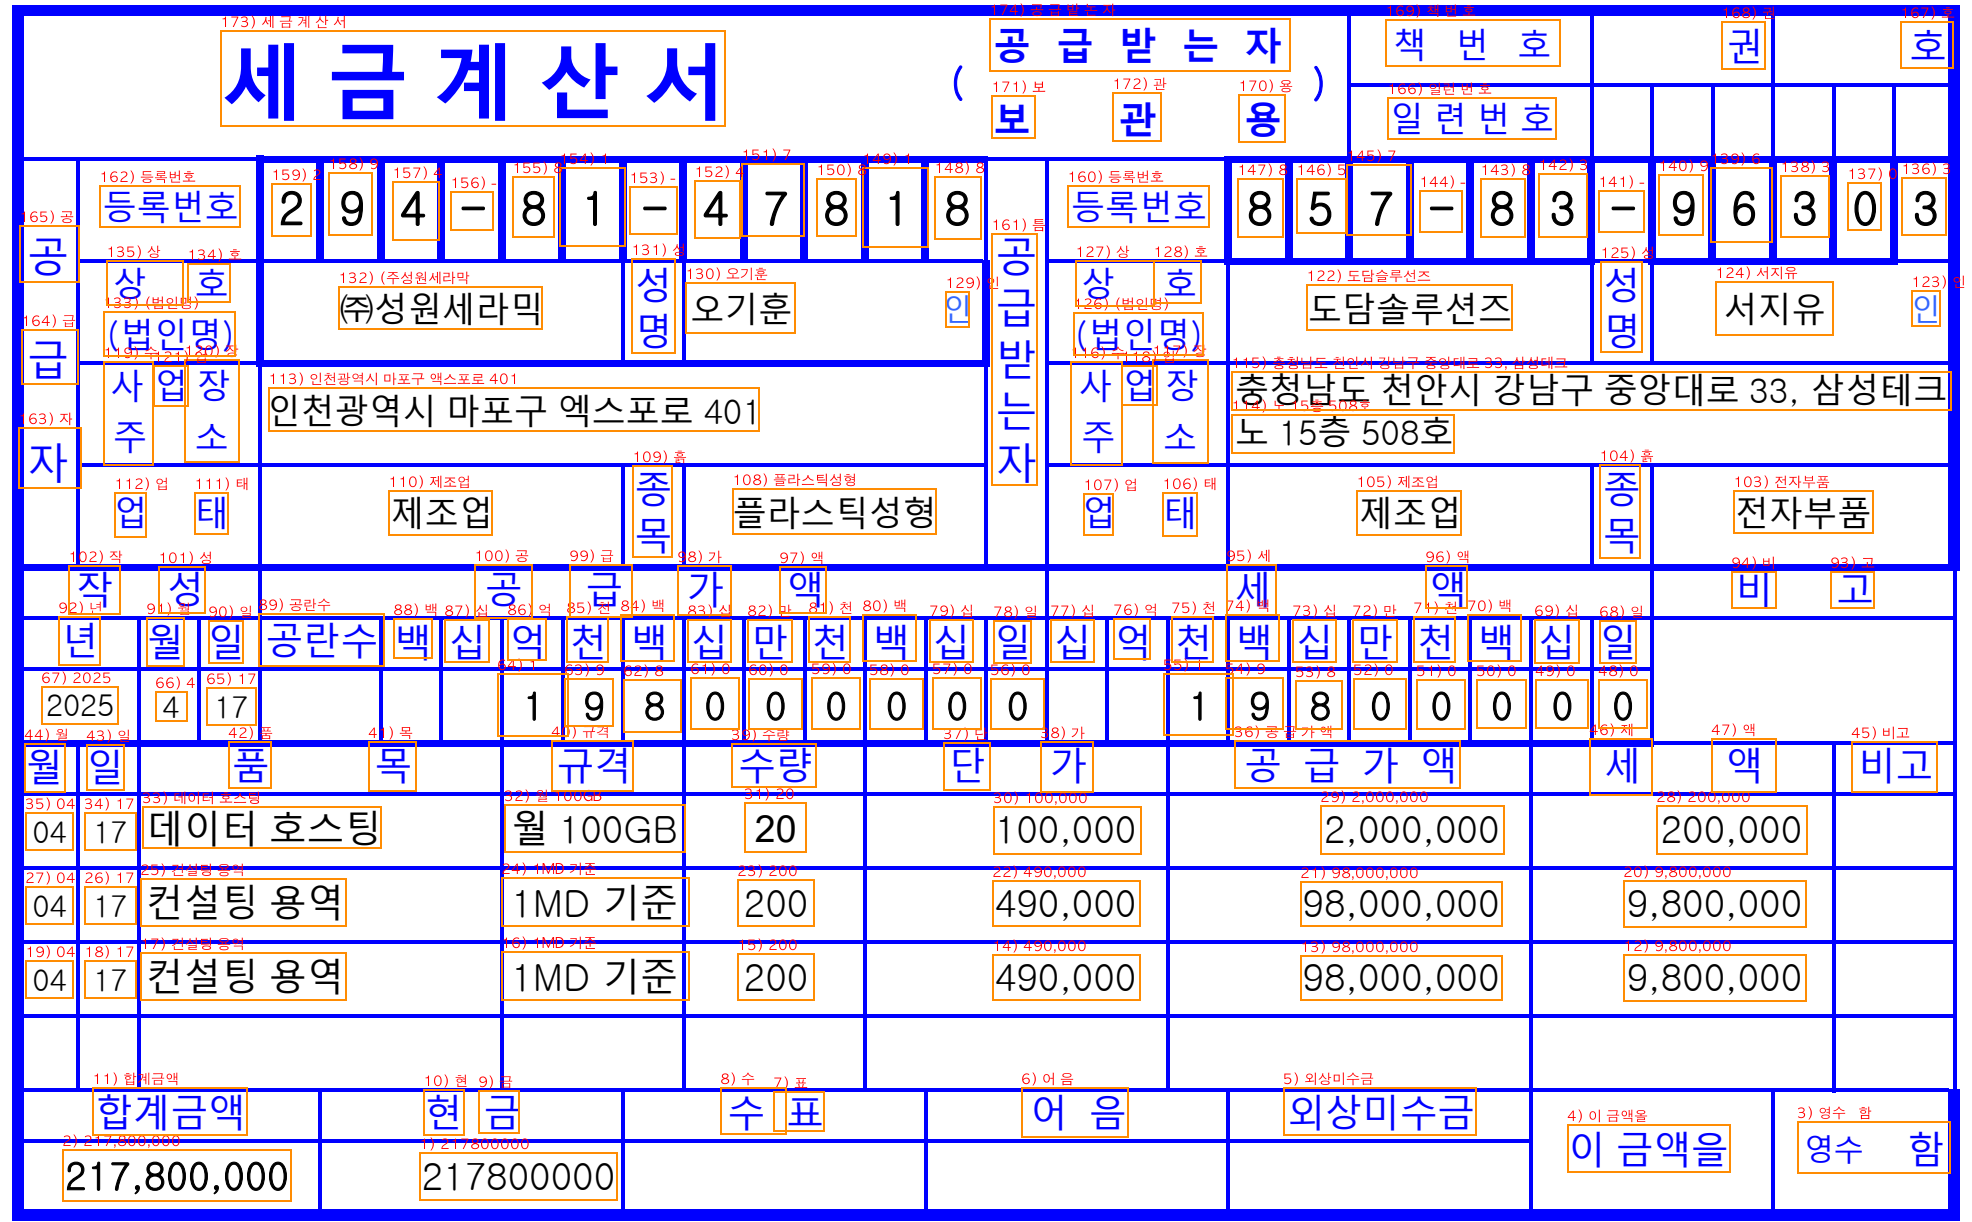
EasyOCR (1.5s) 5. docTR
프랑스의 문서 AI 기업 Mindee가 개발한, TensorFlow 2와 PyTorch를 모두 지원하는 문서 특화 오픈소스 OCR 라이브러리
- 검출(DBNet, LinkNet 등)과 인식(CRNN, SAR, MASTER, ViTSTR 등) 모델을 자유롭게 조합할 수 있는 모듈형 구조
- 출력이 페이지 → 블록 → 라인 → 워드 계층 구조로 나와 문서 레이아웃 파싱에 유리
- 사전학습 모델이 영어·라틴 문자 중심이라 한국어 지원은 사실상 없어 별도 학습이 필요
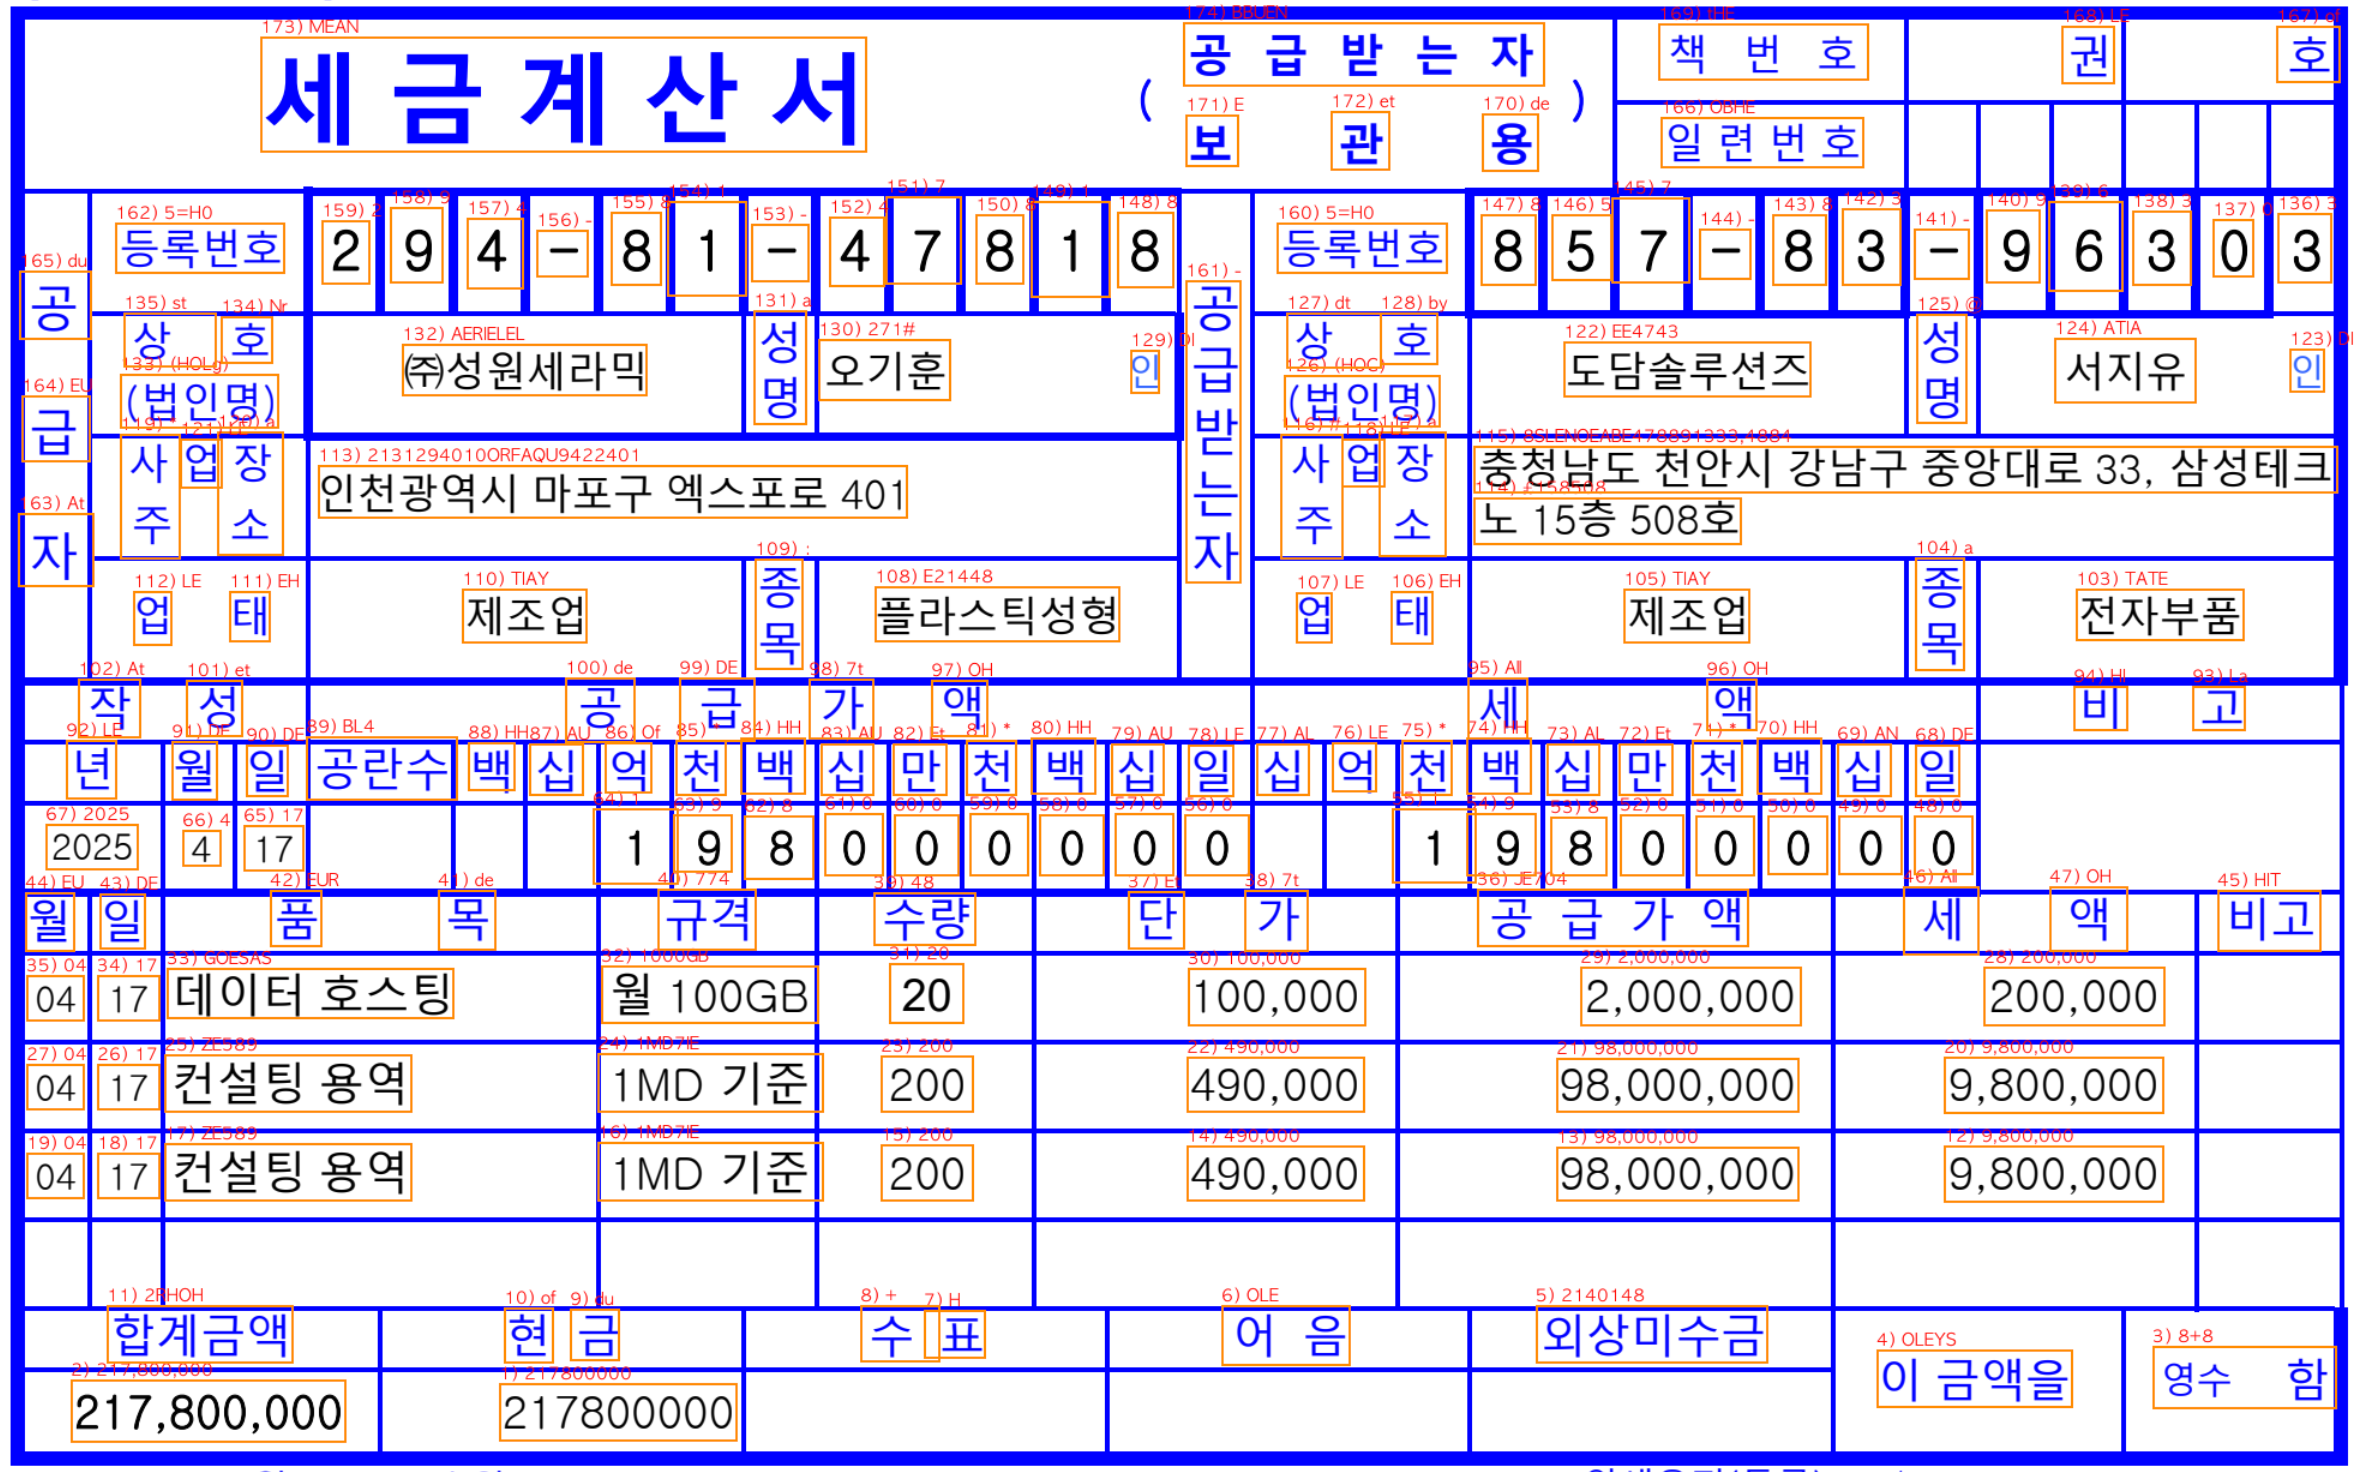
docTR (1.8s) 6. TrOCR-daekeun
AWS 소속 엔지니어가 한국어를 포함한 TrOCR 다국어 모델이 없던 상황에서 PoC 목적으로 직접 학습시킨 한국어 TrOCR 모델 Hugging Face
- 네이버 뉴스 요약 데이터셋, NSMC(네이버 영화 리뷰), 챗봇 데이터셋 3종을 Kiwi 형태소 분석기로 문장 분리해 63만 7천여 샘플을 확보하고, TrOCR 논문에서 쓰인 TextRecognitionDataGenerator로 이미지를 생성해 학습
- 2022년 11월 공개.
- 모델 카드 자체에서 "추가 데이터를 모아 1st stage를 더 학습하거나 fine-tuning할 것을 권장"한다고 밝힐 만큼 PoC 성격이 강함
- 학습 코드 전체가 AWS SageMaker 예제로 공개되어 있어, 한국어 TrOCR을 직접 학습해보는 레퍼런스로서의 가치가 큼
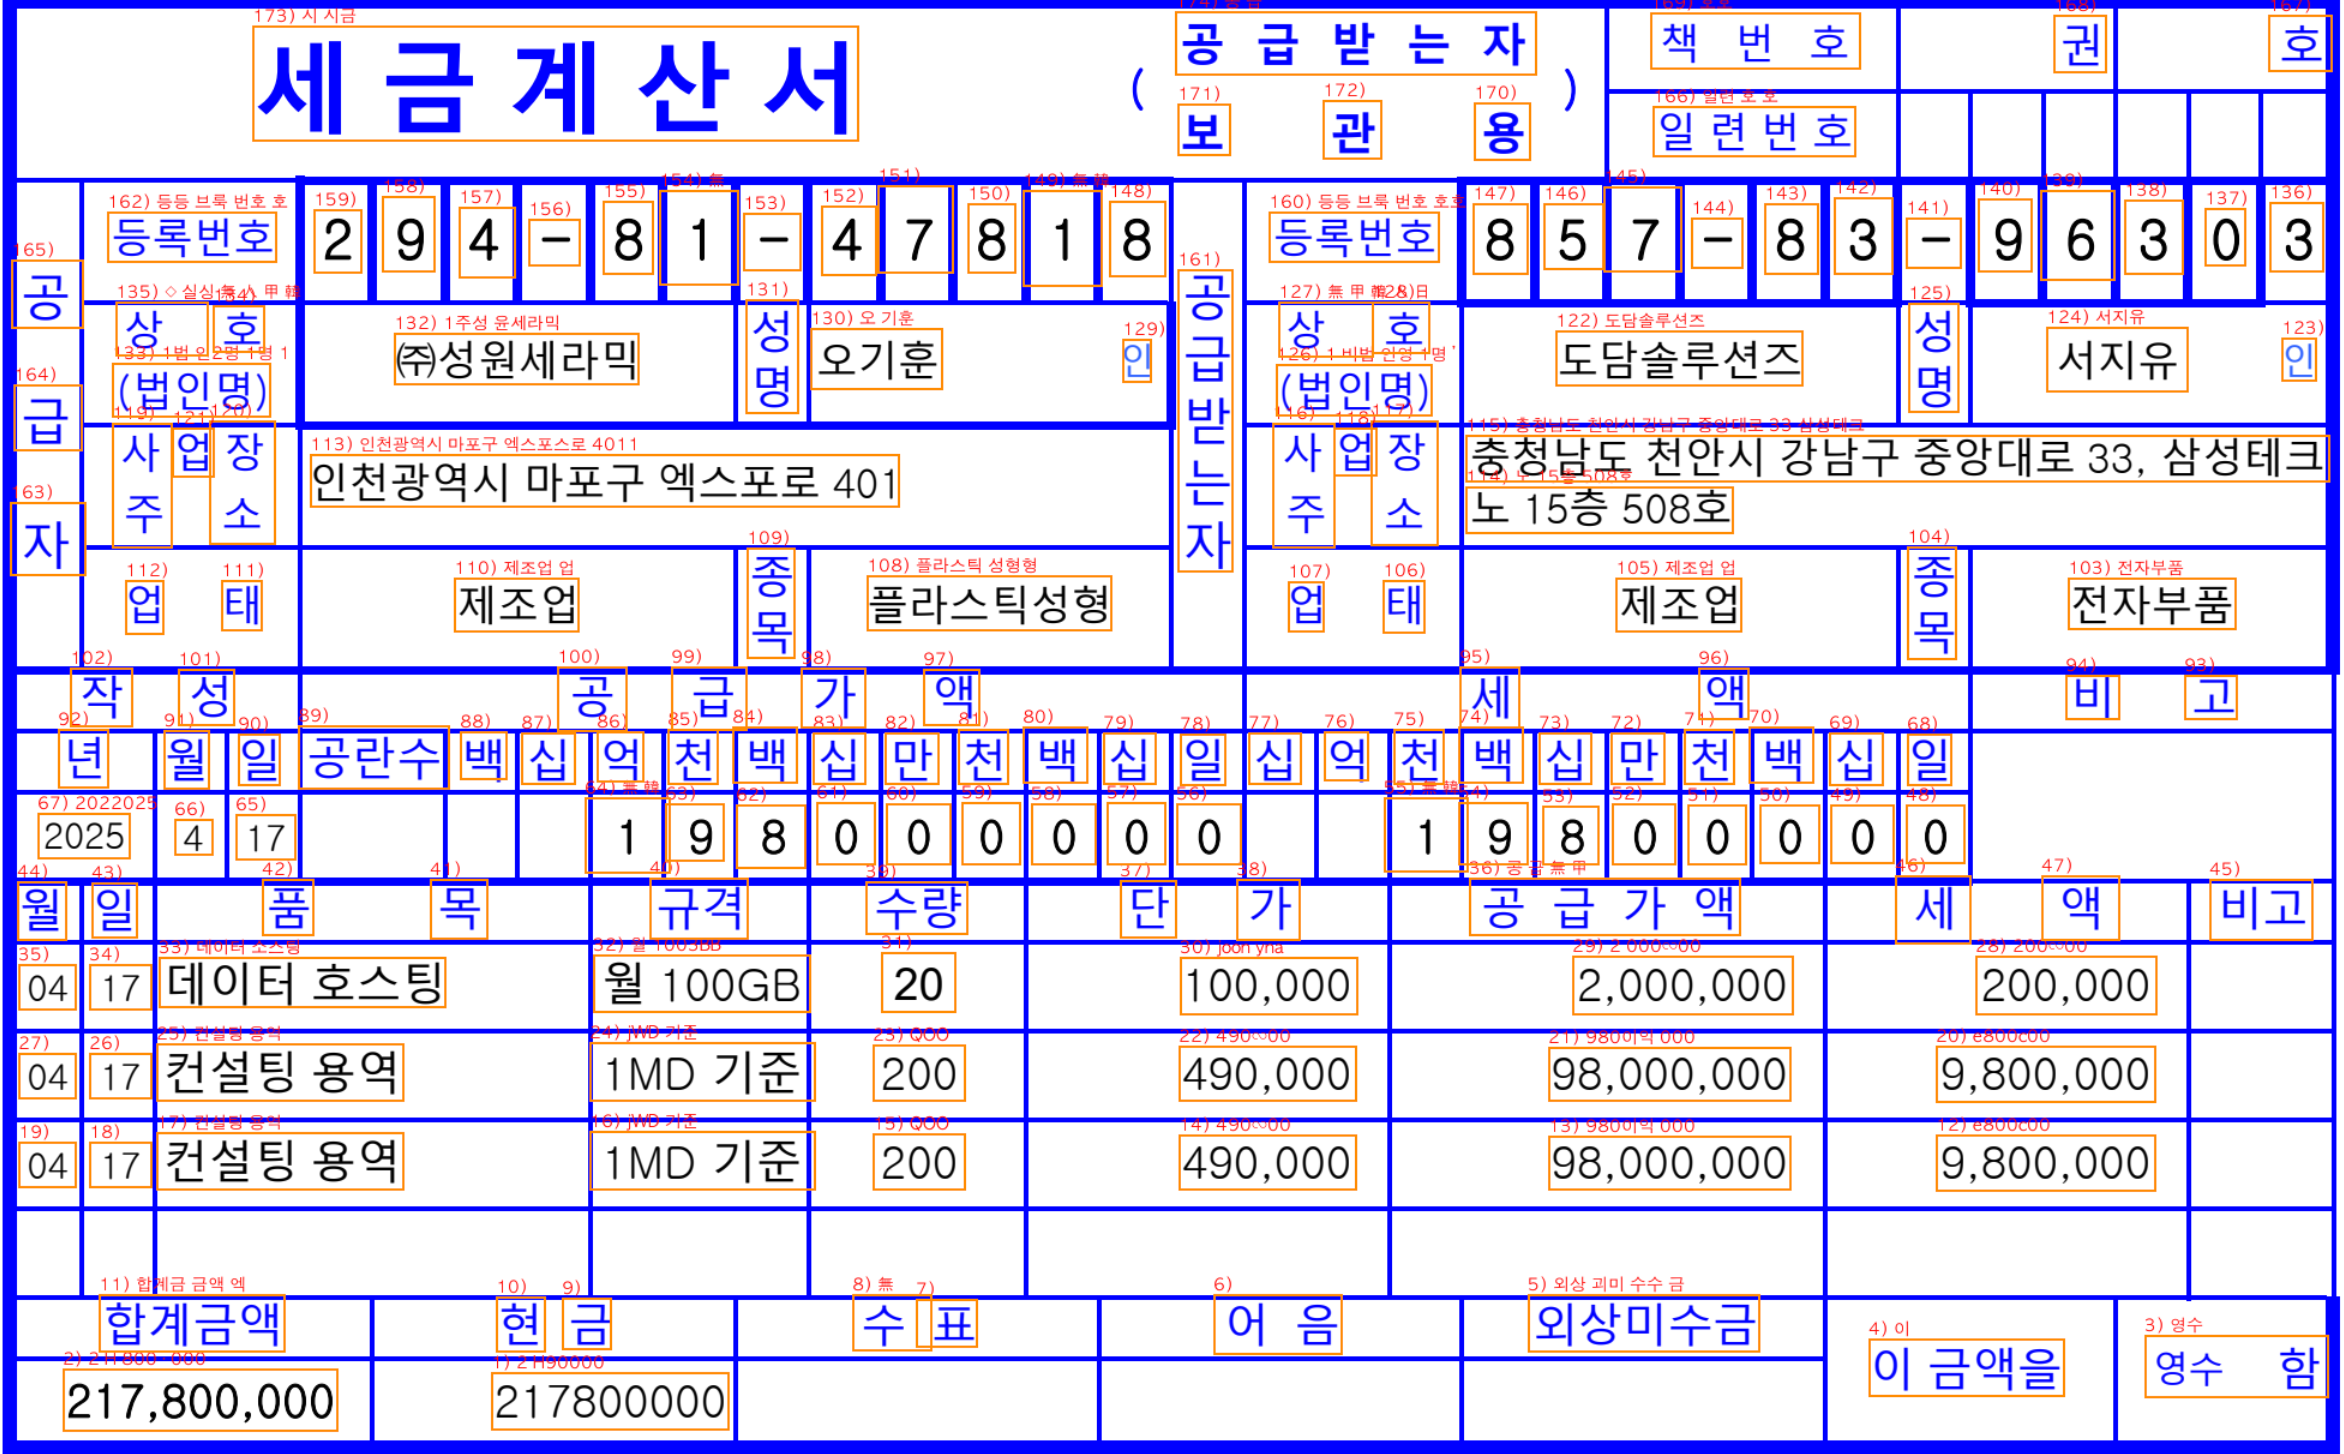
TrOCR-daekeun (82s) 7. TrOCR - team-lucid
마이크로소프트의 TrOCR(Transformer 기반 이미지 인코더 + 텍스트 디코더 구조)을 한국어로 학습시킨 커뮤니티 공개 모델 (Hugging Face)
- 이미지 인코더는 DeiT 가중치로, 텍스트 디코더는 자체 학습한 RoBERTa 가중치로 초기화
- SynthTIGER로 생성한 600만 장의 합성 이미지로 학습(학습률 1e-4, 배치 512, 50만 스텝)되었고, Google TPU Research Cloud 지원을 받아 진행.
- 2023년 7월 공개.
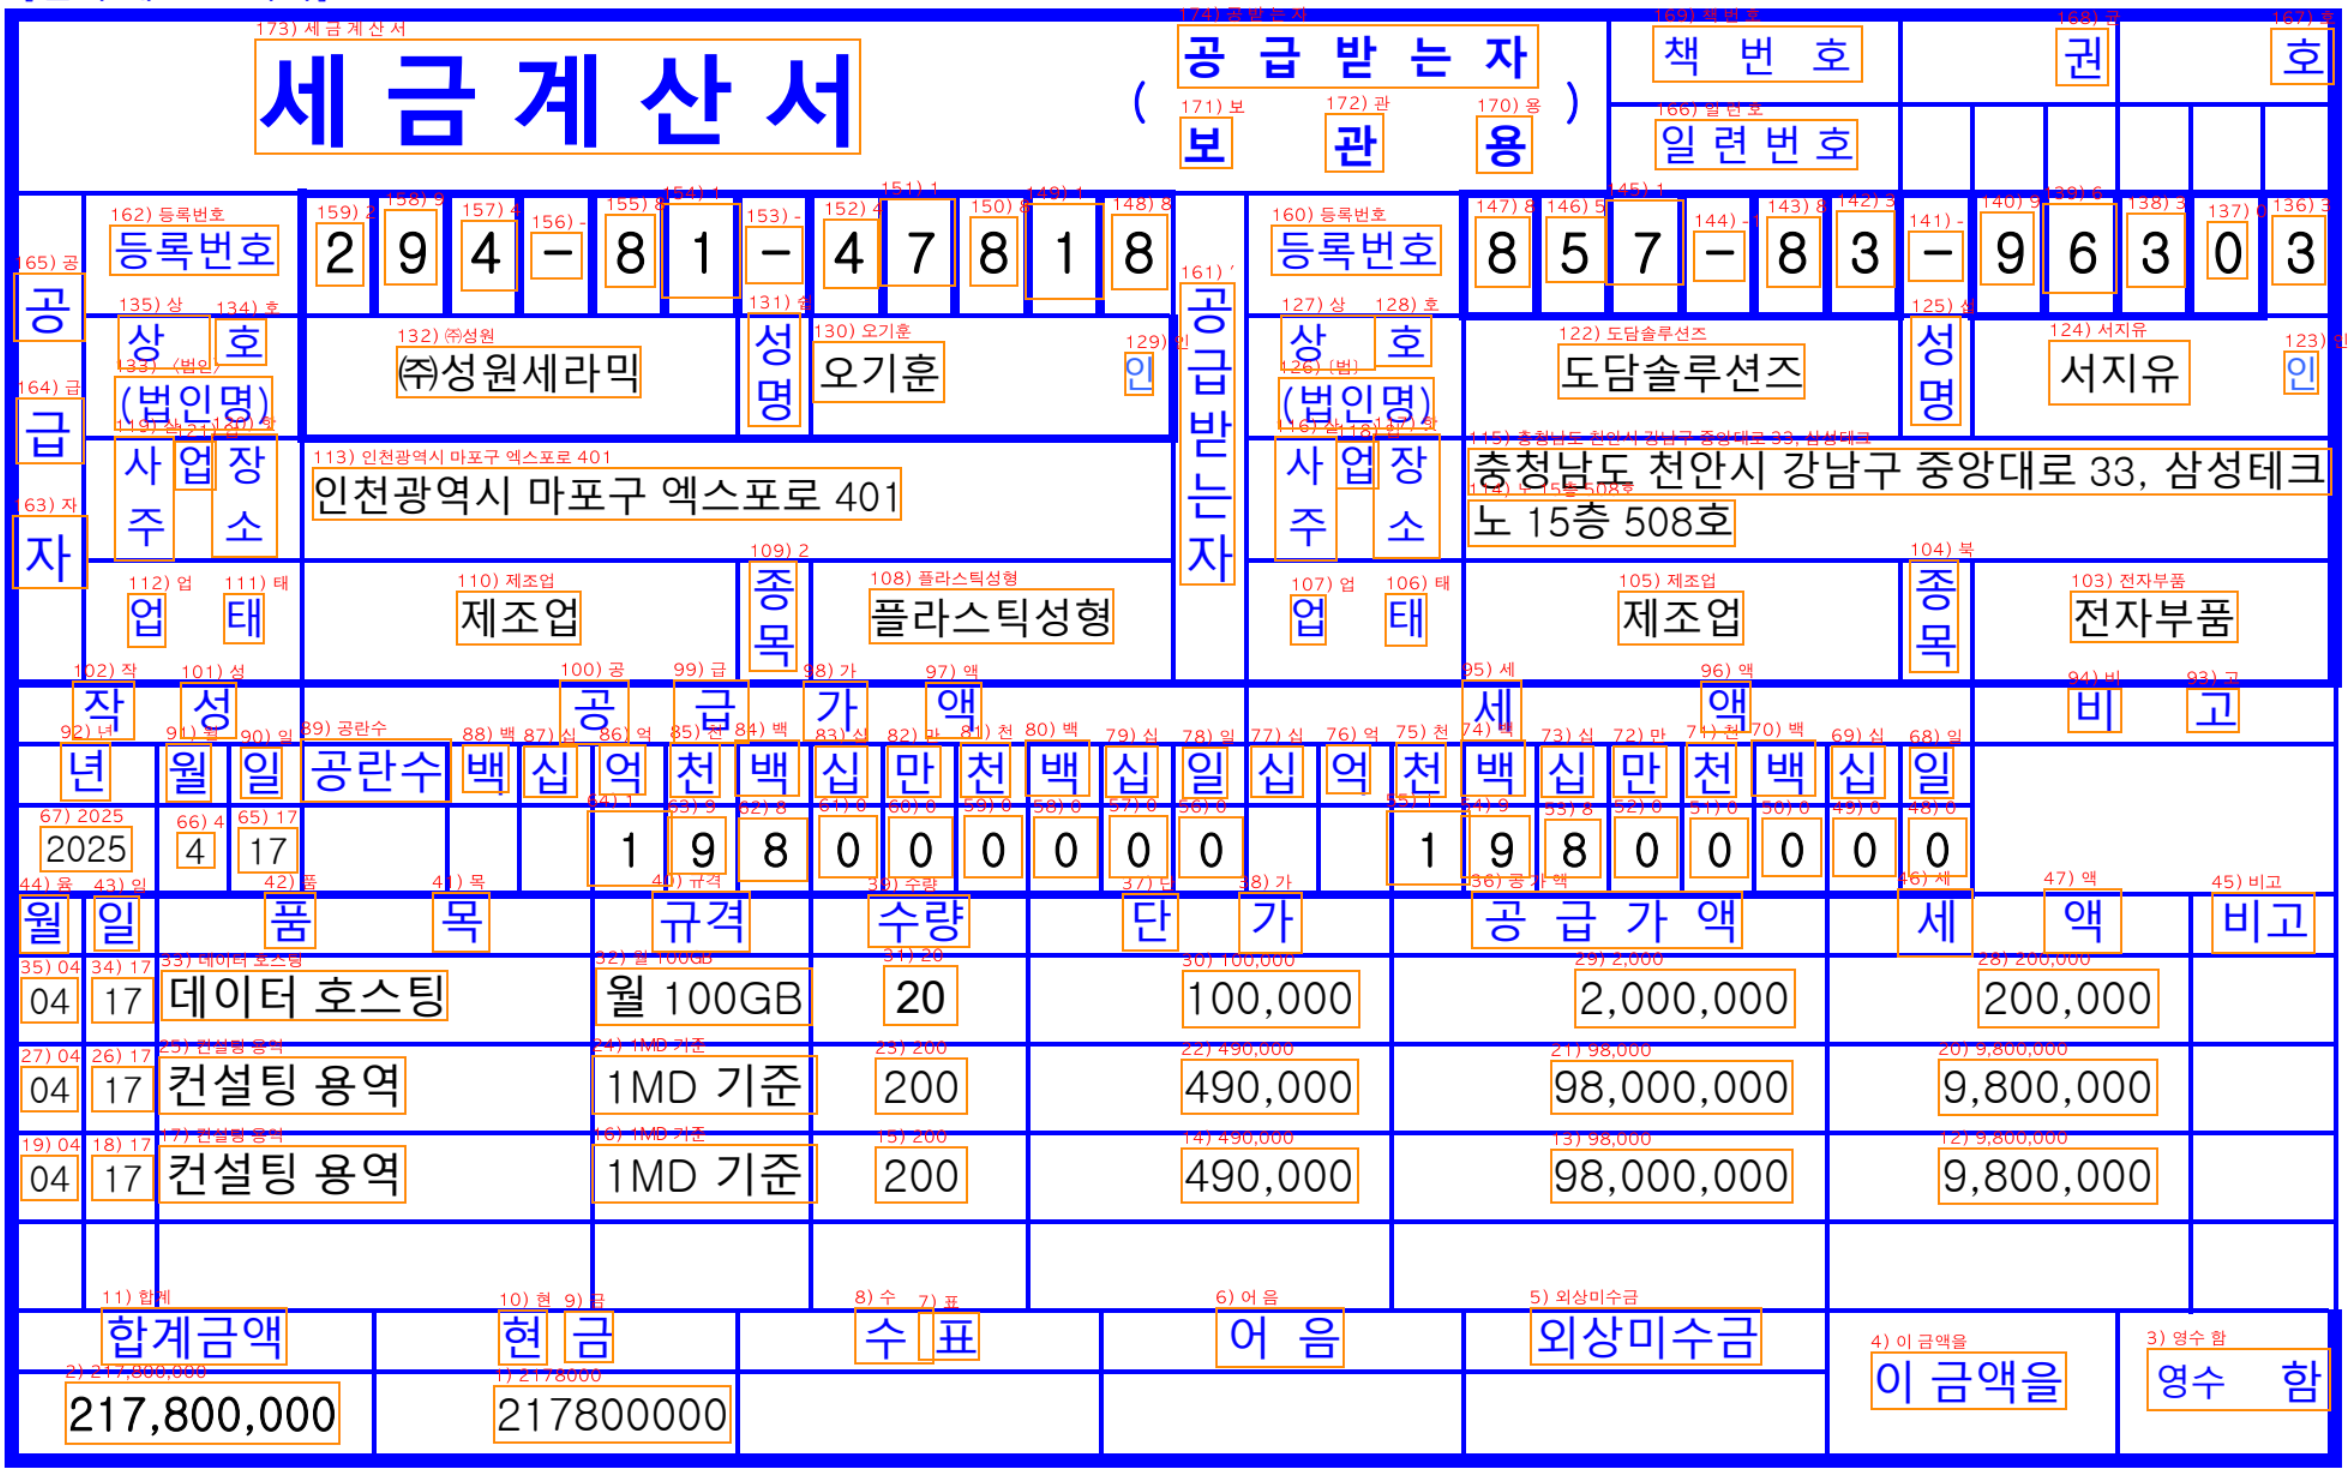
TrOCR - team-lucid (17.2s) 결과 정리
엔진 174개 인식 총 시간 빈칸 품질 PP-OCRv5-mobile-rec 14s 1 최상 (오인 최소) easyocr 1.5s 0 양호 (자음 혼동) doctr 1.8s 0 한글 불가 tesseract 5.2s 2 보통 trocr-team-lucid 17.1s 0 상 trocr-daekeun 82s 123 하 오인식 비교
항목 PP-OCRv5(현행) easyocr ddobokki tesseract 컨설팅 용역 ✅ 건설팅 ✗ 컨설팅용역 ✅ 1MD 기준 ✅ ✅ ✅ 140 기준 ✗ 도담솔루션즈 ✅ 도담슬루선즈 ✗ ✅ ✅ (주)성원세라믹 ✅ (주성원세라막 ✗ ✅ 준성원세라믹 ✗ 엑스포로 401 ✅ 액스포로 ✗ ✅ ✅ 삼성테크노 508호 ✅ 삼성데크 ✗ ✅ ✅ 217800000 ✅ ✅ 21780000 ✗ ✅ - (대시) ✅ ✅ ✅ 뻐 ✗ 종목 (세로쓰기) 족 ✗ 흙 ✗ 종목 ✅ 터 ✗ 성명 (세로쓰기) 성 ✗ 성 ✗ 성명 ✅ 홈 ✗ 사업장주소(세로) 수 ✗ 수 ✗ 사주 ✗ 주 ✗ 공급받는자(세로) ∅(빈칸) ✗ 틈 ✗ 공급반자 △ ∅(빈칸) ✗ 'projects > ocr' 카테고리의 다른 글
세금계산서 ocr - (2) OCR 파이프라인 설계 (0) 2026.07.30 세금계산서 ocr - (1) 딥러닝의 필요성을 느끼다. (1) 2026.07.17 세금명세서 ocr - 릴리즈 노트 (0) 2026.07.16